Pytam bazę po polsku
Mam bazę z ofertami zebranymi przez monitoring Useme — kilkaset wierszy, ocena dopasowania, uzasadnienie, daty. Żeby cokolwiek z niej wyciągnąć, trzeba było usiąść do konsoli i napisać SQL.
Dashboard byłby przesadą: pytania są za każdym razem inne, a raz zbudowany wykres odpowiada tylko na to jedno pytanie, które miałem w głowie, gdy go robiłem.
Zamiast tego postawiłem bota, do którego piszę zdaniem.
Jak to działa
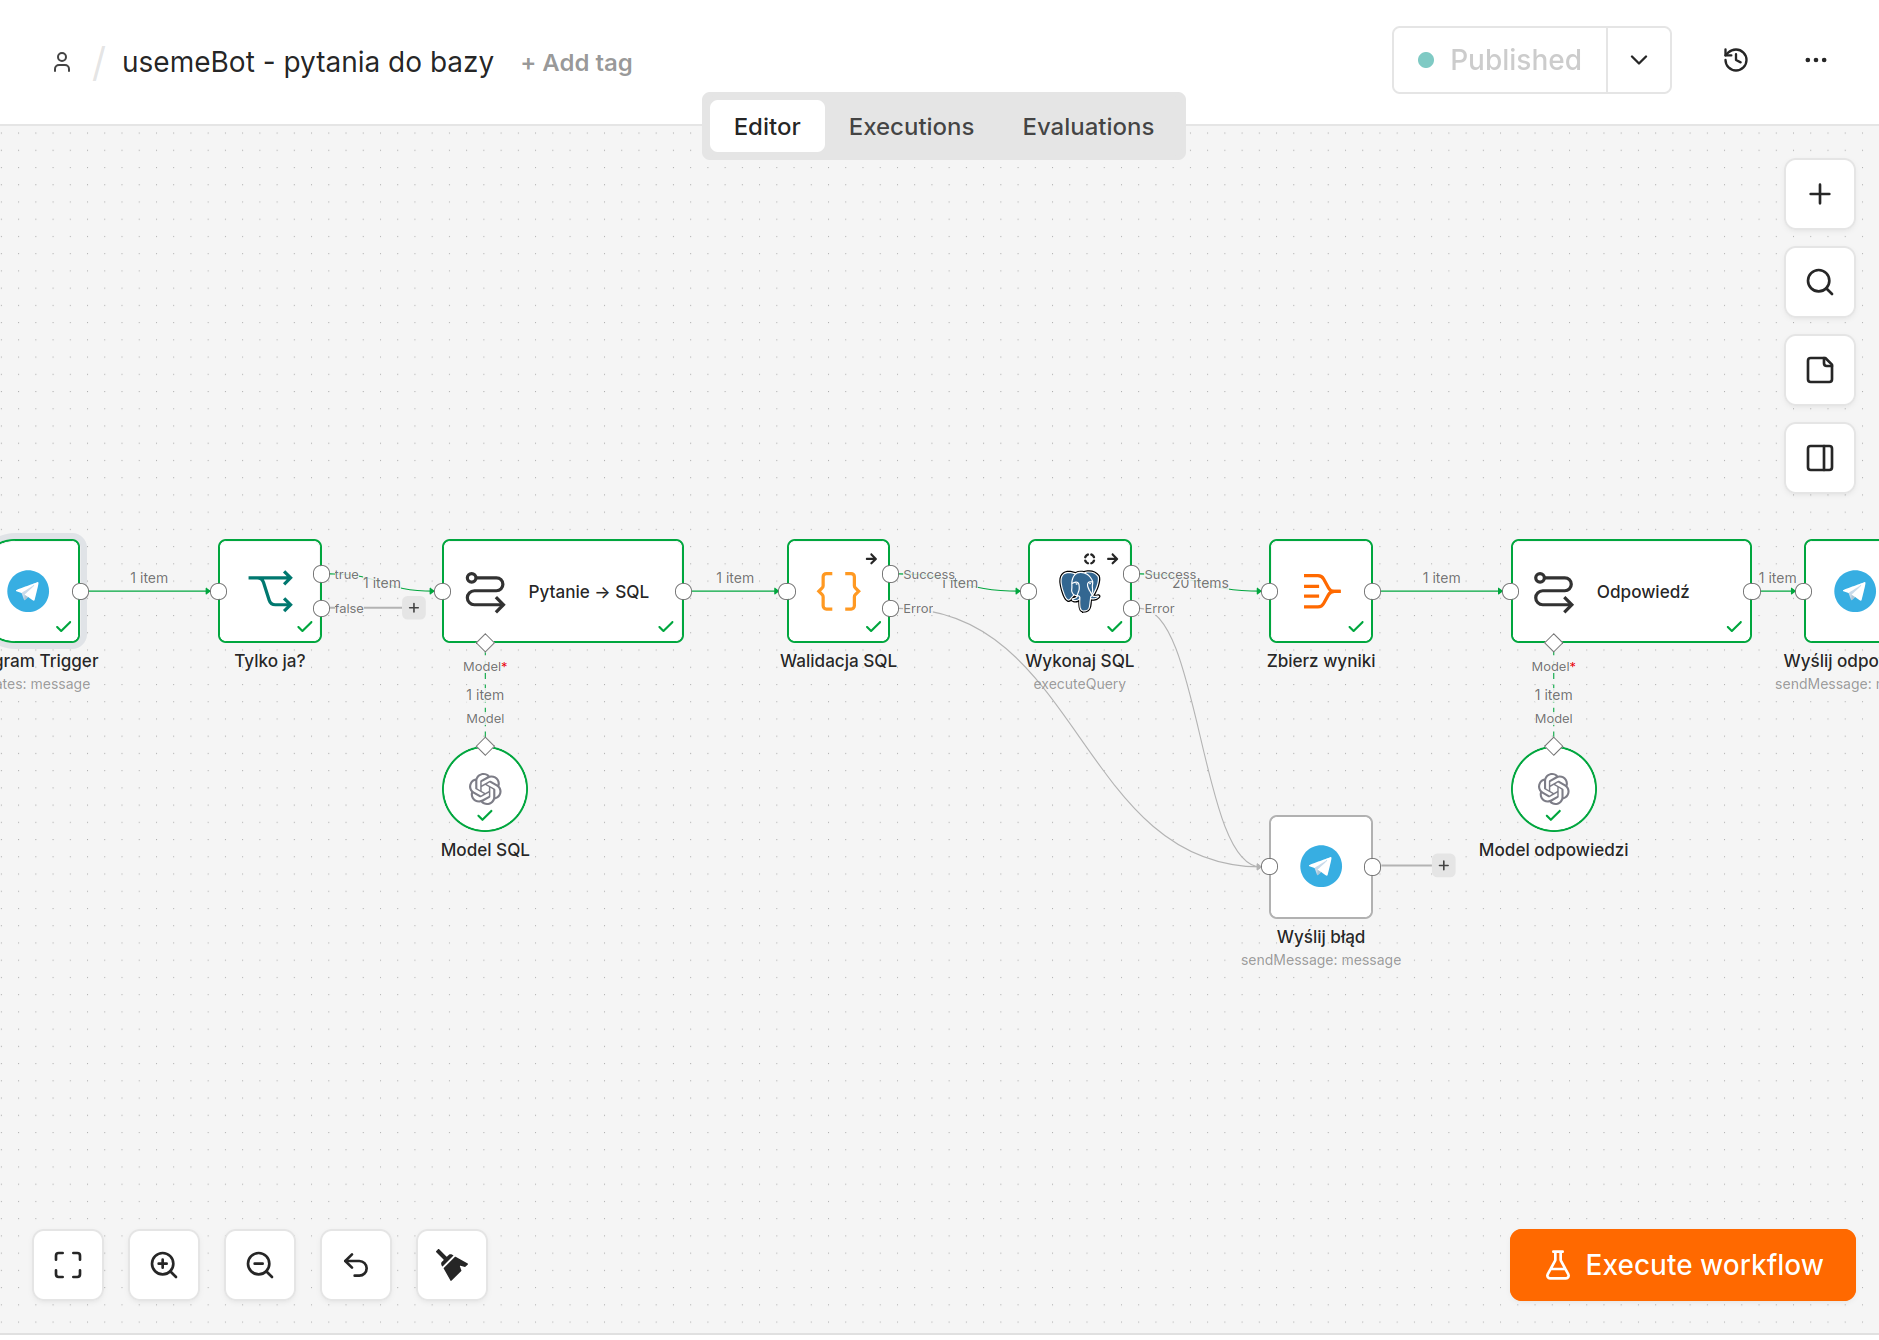
Jedenaście węzłów, pięć kroków:
- wiadomość z Telegrama, przepuszczana tylko od jednego nadawcy,
- gpt-4o zamienia pytanie na zapytanie SQL,
- walidacja — o niej za chwilę, bo to najważniejszy węzeł w całym przepływie,
- Postgres wykonuje zapytanie,
- gpt-4o-mini układa z wierszy odpowiedź po polsku i odsyła ją na Telegram.
Model dostaje schemat, nie dostęp
Pierwszy model nie widzi bazy. Dostaje w prompcie opis tabeli — nazwy kolumn, typy, znaczenie — i ma zwrócić wyłącznie JSON z jednym zapytaniem:
{ "sql": "SELECT count(*) AS liczba FROM useme.offers WHERE ..." }W prompcie siedzą też reguły dziedzinowe, które w innym wypadku musiałbym powtarzać przy każdym pytaniu: że daty względne liczymy w strefie Europe/Warsaw, że szukanie tekstu ma iść przez ILIKE po trzech kolumnach naraz, i że „pasujące” albo „dobre dla mnie” znaczy ai_score >= 6.
Ustawienia modelu: temperature: 0 i wymuszony json_object. Przy generowaniu SQL kreatywność jest wadą, nie zaletą.
Bramka między modelem a bazą
To jest ta część, którą większość demonstracji „text-to-SQL” pomija. Model może się pomylić albo dać się podpuścić treścią pytania — więc jego wyjście nie idzie prosto do bazy, tylko przez węzeł walidujący:
let q = String(raw || '').trim().replace(/;+\s*$/, '');
const forbidden = /\b(insert|update|delete|drop|alter|create|truncate|
                     grant|revoke|copy|call|do|vacuum|set|reset|lock|
                     pg_sleep|pg_read_file|dblink)\b/i;

// literały tekstowe out — żeby oferta o tytule "drop shipping" nie wywaliła zapytania
const bare = q.replace(/'(?:[^']|'')*'/g, "''");

if (!/^(select|with)\b/i.test(bare) || bare.includes(';') || forbidden.test(bare)) {
  throw new Error('Niedozwolone lub puste zapytanie: ' + (q || '(brak)'));
}
if (!/\blimit\s+\d+\s*$/i.test(q)) q = `SELECT * FROM (${q}) AS t LIMIT 50`;
Cztery warunki: zapytanie musi zaczynać się od SELECT albo WITH, nie może zawierać średnika (koniec z doklejaniem drugiej instrukcji), nie może trafić w czarną listę słów i musi mieć limit — a jeśli nie ma, dostaje go opakowaniem.
Najciekawsza jest trzecia linijka. Przed sprawdzeniem czarnej listy wycinam z zapytania wszystkie literały tekstowe. Bez tego pytanie o oferty ze słowem „drop” w tytule zostałoby odrzucone jako próba DROP TABLE. Filtr patrzy na strukturę, nie na dane.
Czarna lista to nie jest zabezpieczenie
Warto to powiedzieć wprost, bo brzmi solidniej, niż jest. Lista zakazanych słów odsiewa pomyłki i oczywiste głupstwa, ale nie jest parserem SQL i nie udaje, że nim jest.
Prawdziwą granicą jest rola w bazie. Ten bot powinien łączyć się użytkownikiem, który ma wyłącznie SELECT na jednym schemacie — wtedy nawet przepuszczone przez filtr zapytanie nie ma czego zepsuć. Walidacja jest pierwszą warstwą, uprawnienia drugą i to ta druga jest nieprzekraczalna.
Drugi model tylko mówi
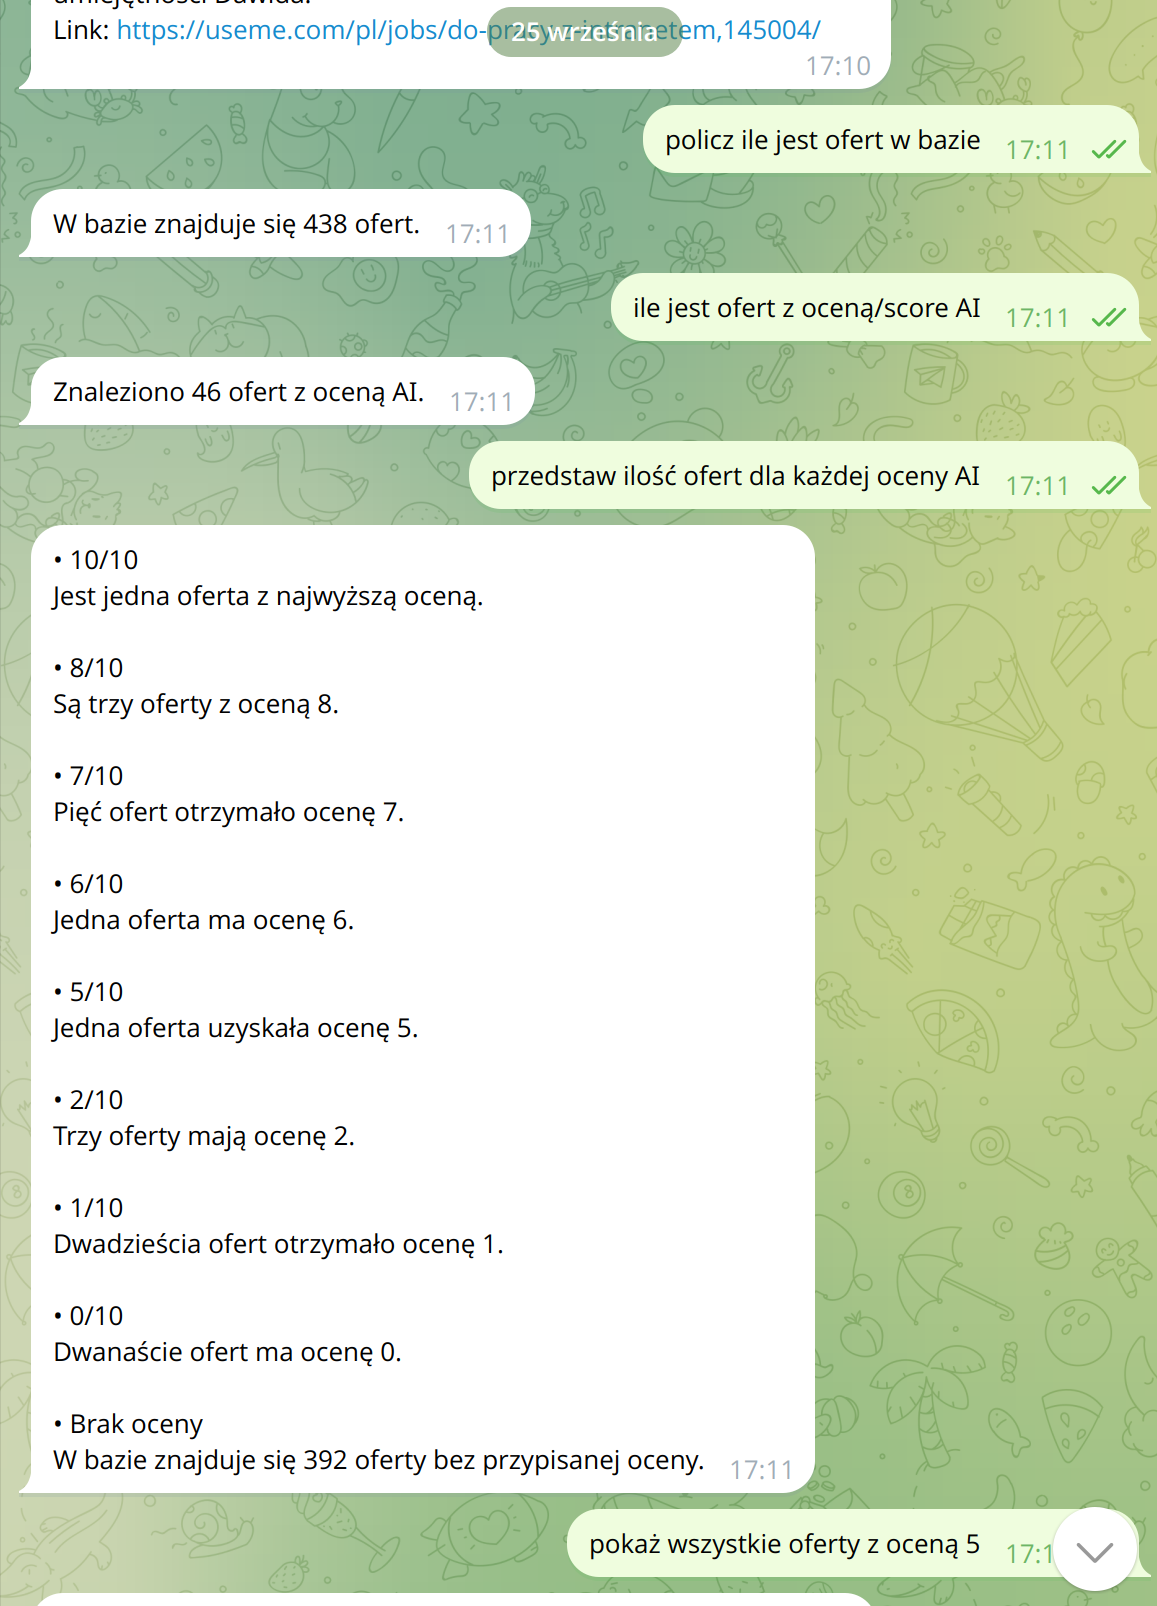
Wiersze z bazy trafiają do drugiego modelu, który ma jedno zadanie: ubrać je w zdanie po polsku. Nie liczy, nie zgaduje, nie uzupełnia — w prompcie ma wprost napisane, żeby nie wymyślał danych, których nie ma w wynikach, i żeby przy pustym zbiorze po prostu napisał, że nic nie znalazł.
Dlatego tu wystarcza gpt-4o-mini. Trudna część — przełożenie pytania na zapytanie — już się wydarzyła. Redagowanie zdania z gotowych liczb jest tanie.
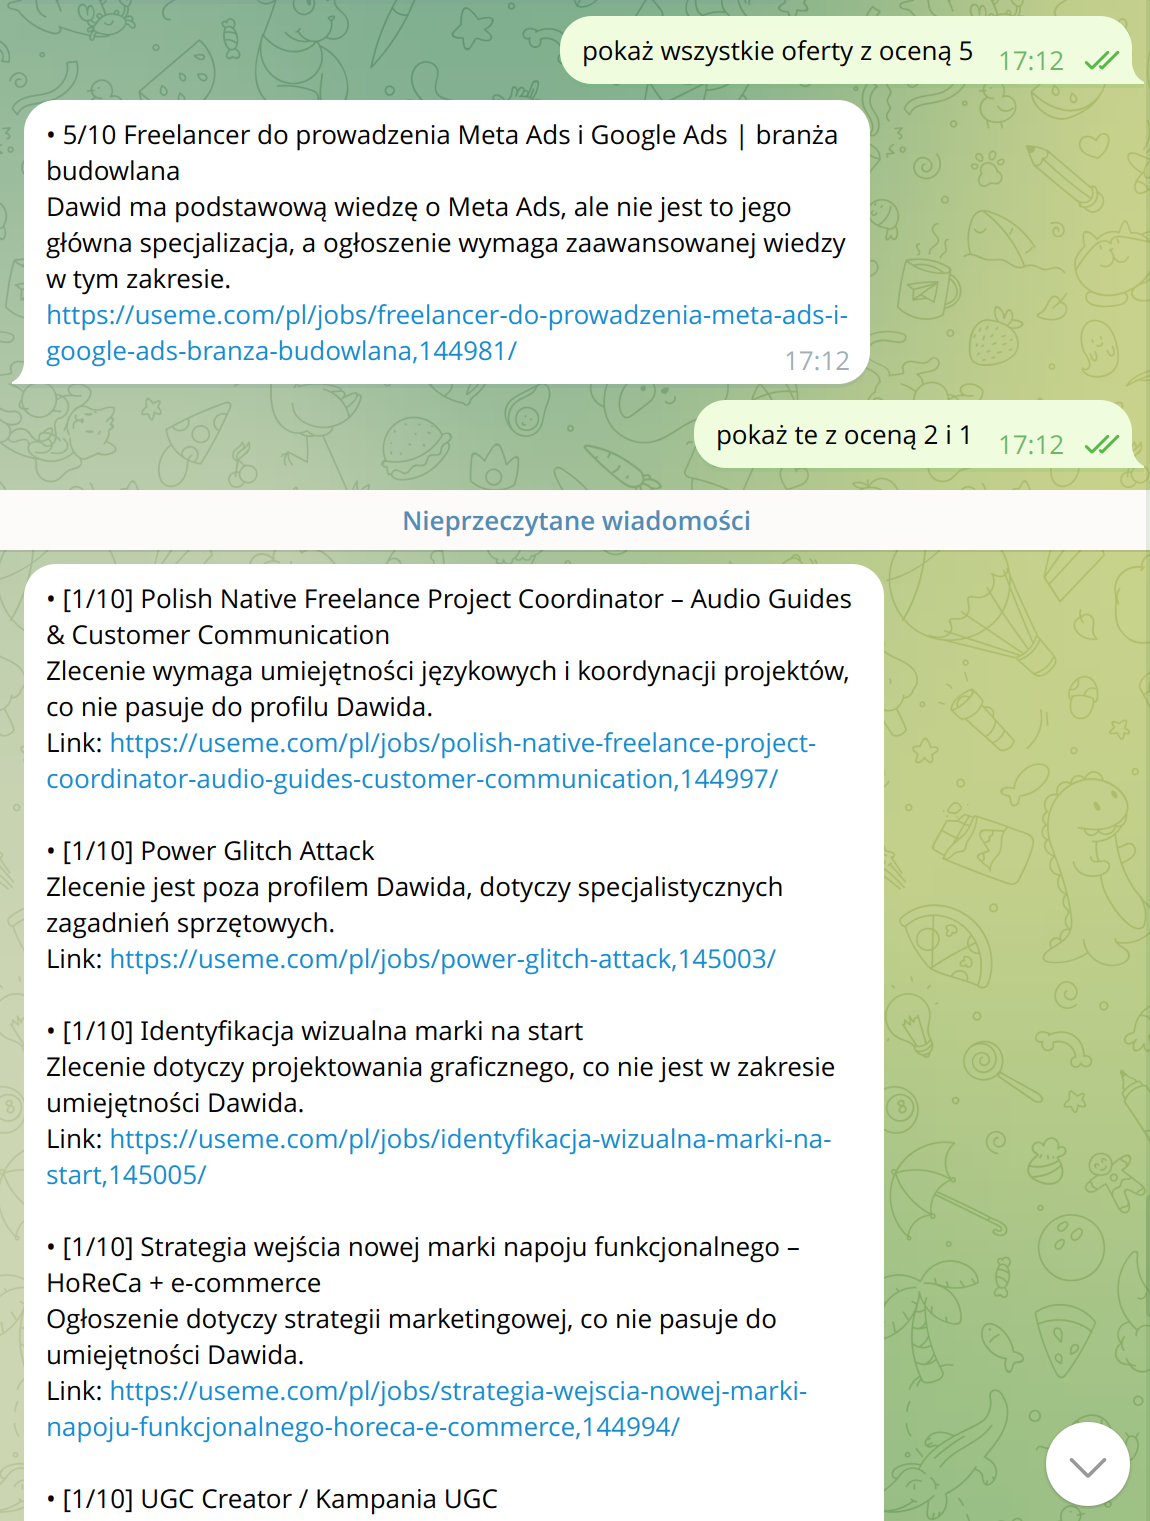
Pytania idą jedno za drugim, bez powtarzania kontekstu: „pokaż wszystkie oferty z oceną 5”, potem „pokaż te z oceną 2 i 1”. Każde jest tłumaczone osobno, więc bot nie pamięta rozmowy — i przy tym zastosowaniu okazuje się, że nie musi.
Gdy coś pójdzie nie tak
Zarówno walidacja, jak i wykonanie zapytania mają wyjście błędu podpięte do osobnego węzła Telegrama. Dostaję wtedy wiadomość z treścią błędu i z zapytaniem, które go wywołało.
To drobiazg, który zamienia debugowanie z zagadki w czytanie. Widzę, co model napisał, i od razu wiem, czy poprawić prompt, czy rozszerzyć opis schematu.
Co z tego wynika
Wzorzec nie ma nic wspólnego z ofertami zleceń: pytanie w języku naturalnym → model pisze zapytanie → bramka je sprawdza → baza wykonuje → drugi model formułuje odpowiedź.
Podstaw pod bazę stan magazynu, rejestr faktur albo tabelę zamówień, a dostajesz narzędzie, z którego korzysta ktoś, kto nigdy nie napisze SQL-a i nie będzie klikał w filtry raportu.
Koszt wejścia jest niski, ale dwie rzeczy trzeba zrobić porządnie: opisać schemat tak, żeby model rozumiał znaczenie kolumn, a nie tylko ich nazwy — i odciąć mu wszystko poza odczytem.