Bot, który czyta za mnie ogłoszenia
Przeglądanie giełdy zleceń to praca, która wygląda na darmową, a nie jest. Wchodzisz, odświeżasz, przeglądasz dwadzieścia tytułów, z czego osiemnaście nie ma z tobą nic wspólnego. Robisz to pięć razy dziennie i masz z tego godzinę tygodniowo, za którą nikt nie płaci.
Zbudowałem workflow, który robi to za mnie co trzydzieści minut i odzywa się wyłącznie wtedy, gdy ma coś do powiedzenia.
Jak to działa
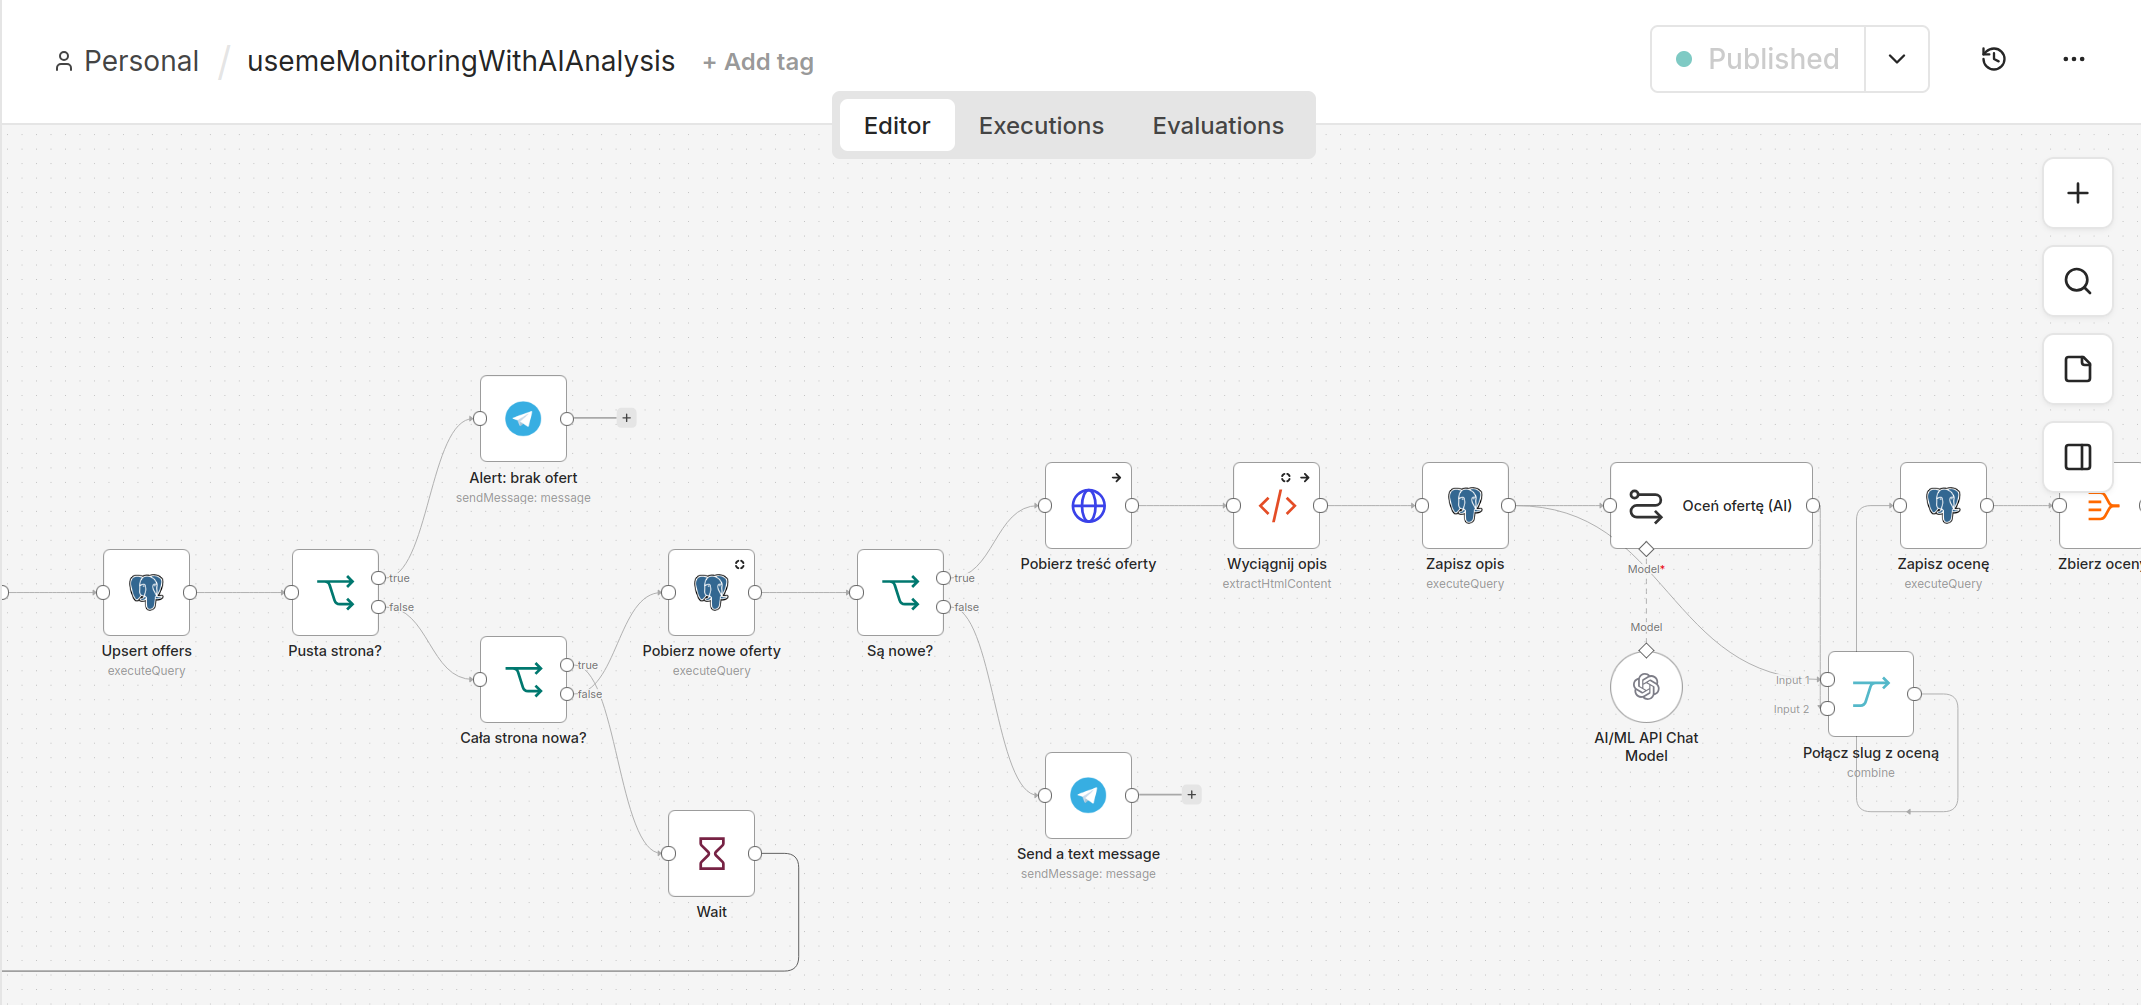
Harmonogram budzi workflow co pół godziny. Ten pobiera listę zleceń posortowaną po dacie publikacji, rozbiera HTML na tablicę ofert i wyciąga z każdej osiem pól — tytuł, firmę, budżet, kategorię, termin, krótki opis.
Potem zaczyna się część, która odróżnia automat od skryptu.
Deduplikacja, czyli po co tu baza
Bez pamięci taki bot przy każdym uruchomieniu uznałby wszystkie oferty za nowe i zasypał mnie powiadomieniami. Dlatego każda oferta trafia do Postgresa przez INSERT ... ON CONFLICT, po slugu ogłoszenia. Baza sama rozstrzyga, co jest nowe.
WITH ins AS (
  INSERT INTO useme.offers (slug, offer_nr, company, title, budget, category, expires, short_description)
  SELECT ... ON CONFLICT (slug) DO UPDATE SET ...
)
SELECT slug, title, company, category, short_description
  FROM useme.offers WHERE first_seen >= $1::timestamptz ORDER BY first_seen;
Kolumna first_seen jest tu całą logiką „co się zmieniło od ostatniego razu”. Nie trzymam żadnego stanu w n8n — stan jest w bazie, gdzie jego miejsce.
Ocena przez LLM
Nowe oferty dostają dociągnięty pełny opis ze strony ogłoszenia, a potem trafiają do modelu gpt-4o-mini z moim profilem w prompcie. Model zwraca JSON z dwoma polami:
{ "score": 7, "reason": "Django + REST API, dokładnie mój stack" }Ocena i uzasadnienie lądują w tym samym wierszu co oferta — ai_score i ai_reason. Próg dopasowania ustawiłem na 6 na 10. Wszystko poniżej istnieje w bazie, ale nie zawraca mi głowy.
Dlaczego najtańszy model? Bo zadanie jest proste: „czy ten opis pasuje do tego profilu”. Nie potrzebuję tu rozumowania, potrzebuję konsekwentnego sita przy dwustu ofertach miesięcznie.
Wiadomość, która ma sens
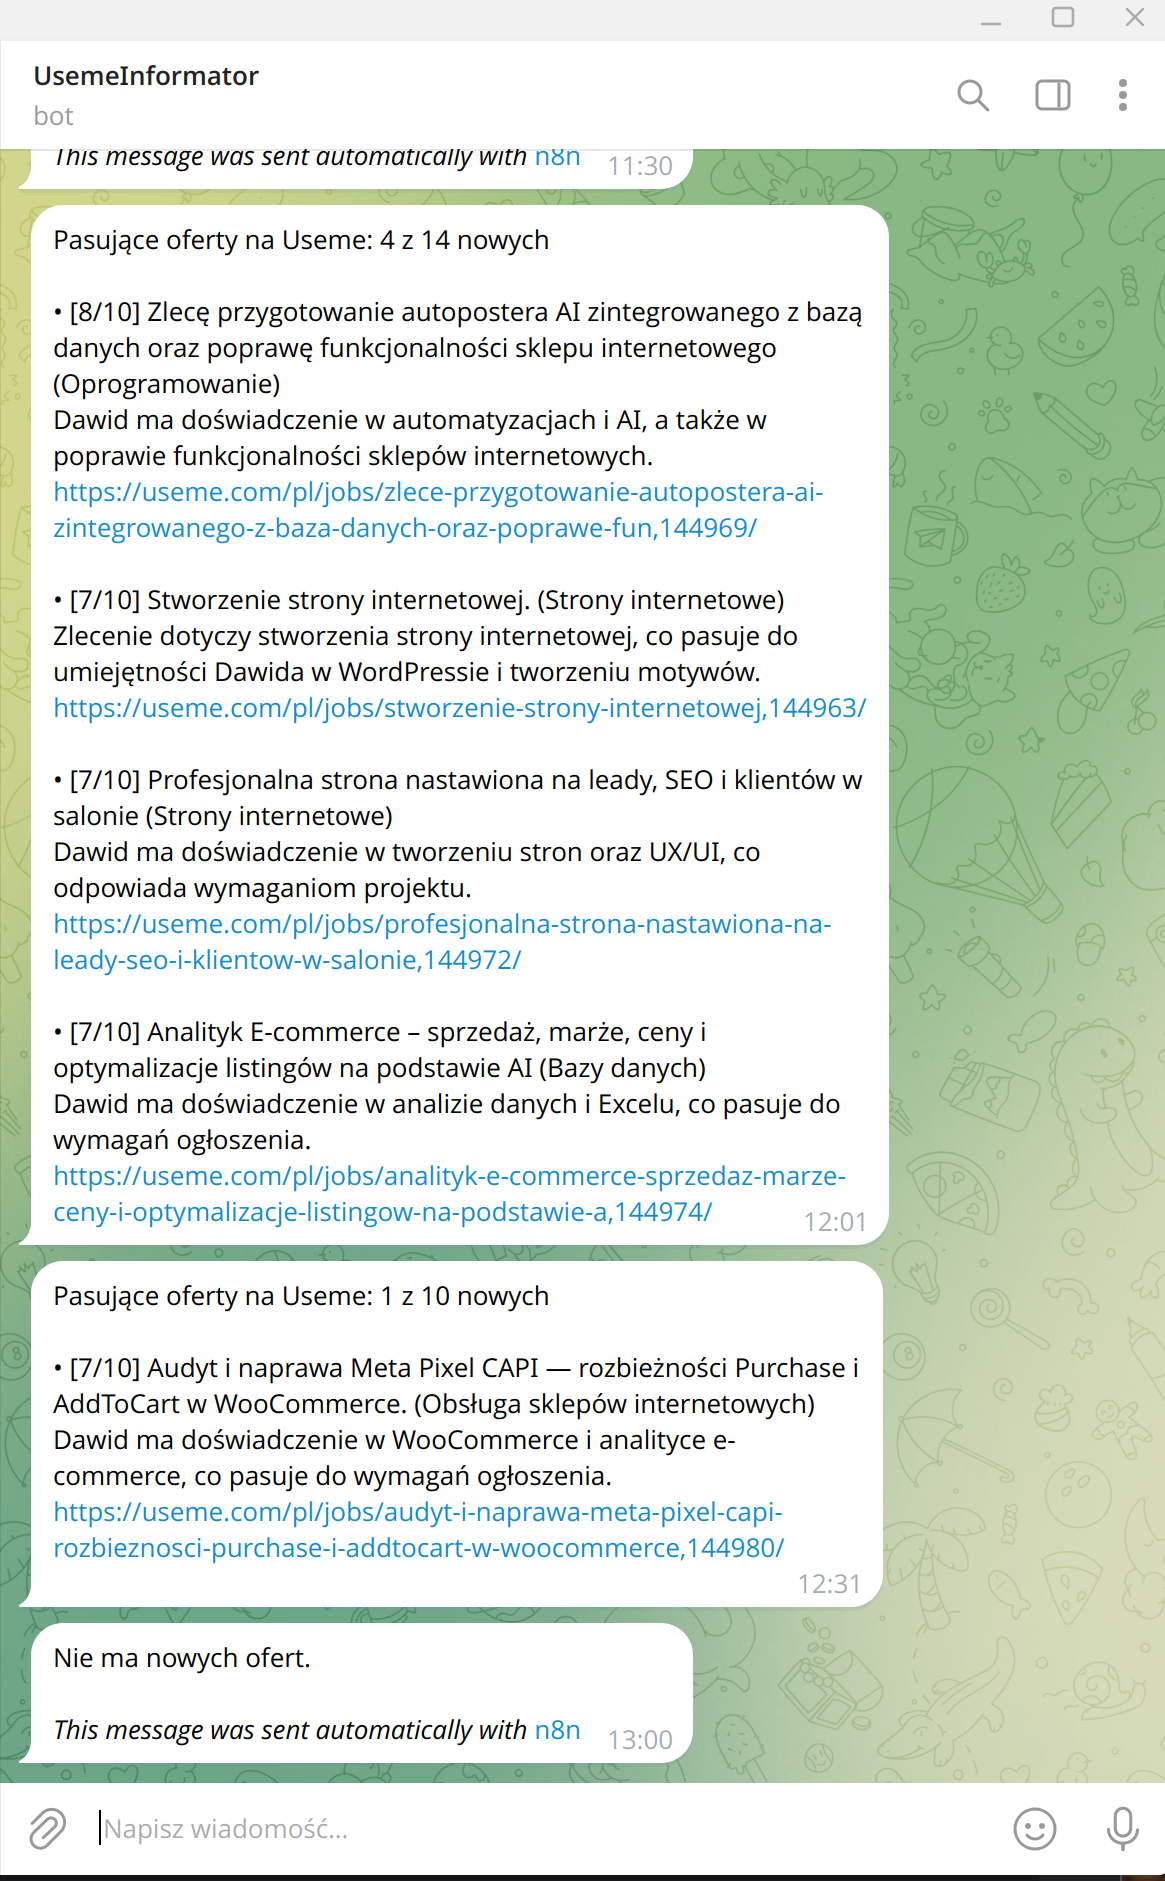
Podsumowanie powstaje jednym zapytaniem — liczba nowych ofert, liczba pasujących i gotowa lista pozycji posortowana po ocenie:
SELECT count(*) AS cnt,
       count(*) FILTER (WHERE ai_score >= 6) AS fit_cnt,
       string_agg('• [' || ai_score || '/10] ' || title || ' (' || coalesce(category,'-') || ')', E'\n')
  FROM ...
W praktyce wygląda to tak: „Pasujące oferty na Useme: 4 z 14 nowych”, a pod spodem cztery pozycje z oceną, jednozdaniowym uzasadnieniem i linkiem. Jeśli fit_cnt wynosi zero, dostaję jedno zdanie zamiast listy. To brzmi jak drobiazg, ale decyduje o tym, czy po tygodniu wyciszysz powiadomienia, czy nie.
Ścieżki błędu są całą robotą
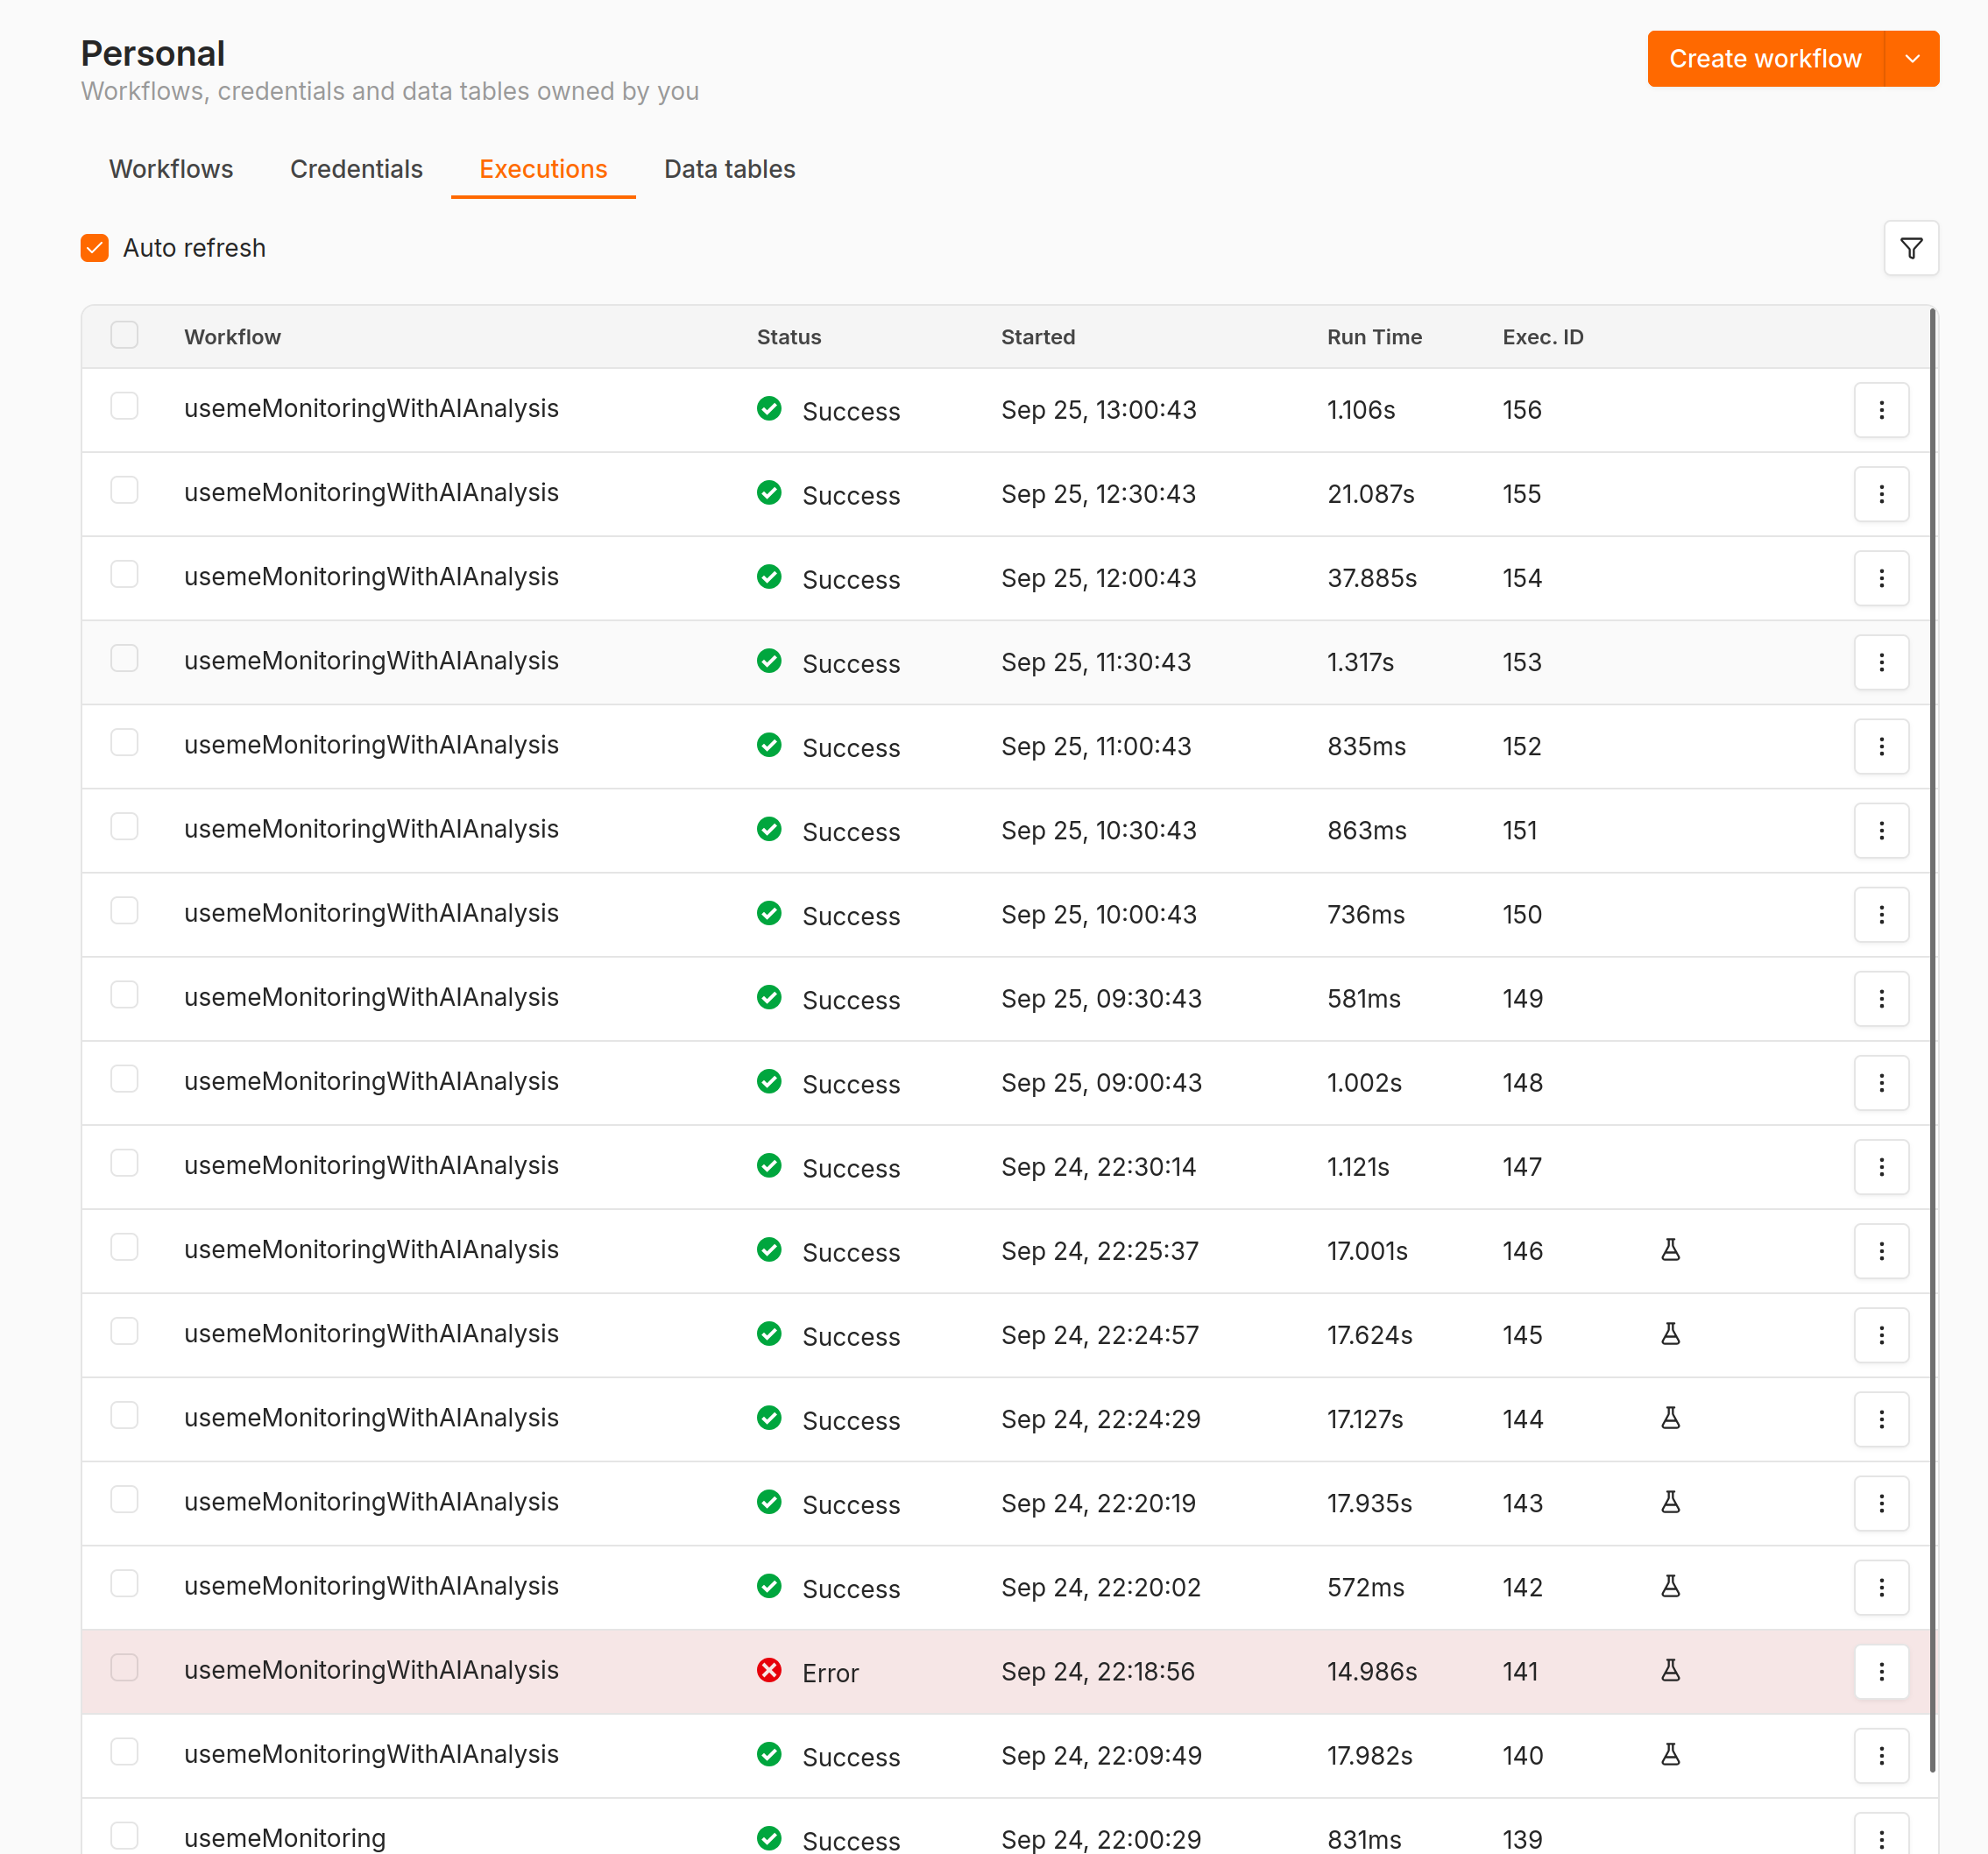
Wersja, która tylko działa, ma może osiem węzłów. Moja ma dwadzieścia osiem i różnica siedzi prawie w całości w rzeczach, które mogą pójść nie tak:
- Useme nie odpowiada — alert na Telegram, zamiast cichej awarii,
- pusta strona — osobny komunikat, bo to zwykle znaczy, że zmienił się HTML i parser przestał trafiać,
- cała strona oznaczona jako nowa — węzeł
Waiti zejście na kolejną stronę, bo to sygnał, że ofert przybyło więcej, niż mieści się na jednej.
Na liście uruchomień powyżej widać jeden czerwony wiersz z 24 września. Właśnie po to są te alerty — dowiedziałem się o tym z Telegrama, a nie z faktu, że przez tydzień nic nie przychodziło.
Ten trzeci przypadek jest najciekawszy. Jeśli wszystkie dwadzieścia ofert na stronie jest nowych, to znaczy, że prawdopodobnie część wypadła już na stronę drugą i właśnie ją przegapiłem. Pobranie kolejnej strony kosztuje jedno zapytanie, a przegapione zlecenie kosztuje zlecenie.
Co z tego wynika
Ten workflow pilnuje giełdy zleceń, ale wzorzec nie ma z giełdą nic wspólnego: monitoruj źródło → odsiej duplikaty → oceń treść modelem → powiadom, gdy warto.
Podstaw pod „źródło” przetargi publiczne, zmiany cen u konkurencji, nowe wpisy w KRS albo skrzynkę zapytań ofertowych — reszta zostaje taka sama. Zmienia się prompt i parser, nie architektura.
Najdroższa część nie jest techniczna. To ustalenie, co właściwie znaczy „pasuje”, i zapisanie tego tak, żeby model rozumiał to za każdym razem tak samo.